ERRATA ・ 勘誤與補充說明
勘誤與補充:定稿之後的修訂
《AI 賦能倉儲與運輸管理——以系統思維邁向雙軸轉型》定稿出版後陸續整理的勘誤與補充。閱讀各章時,請以本頁修訂文為準。
CH03 ・ 勘誤與補充說明|2026-10-09
第 3 章 物流問題的解決邏輯:決策觀點
前往第 3 章 →一、修訂目的
本章借用統計學的 CFA 與 EFA 作為兩階段決策金字塔分析階段的思維工具。現行文字有幾處容易讓熟悉統計的讀者產生誤解,包括:把 CFA 描述為驗證「因果」、把 EFA 結果直接視為「真因」,以及「先驗後探/先探後驗」的用語和學術慣例看起來互相衝突。此外,有少數步驟編號與用詞沒有和現行七步驟模型同步。以下列出逐項勘誤,並提供一段可插入正文的補充說明。
二、勘誤表
| # | 頁碼/位置 | 原文 | 修訂文 | 理由 |
|---|---|---|---|---|
| 1 | 3-6 Step 2 定義段 | 白話講:「你猜的因果,統計說得同意嗎?」 | 白話講:「你猜的原因,資料支不支持?」 | 嚴格的 CFA 只說明資料是否支持假設的結構,不能證明因果 |
| 2 | 3-11 Step 3.5 末段 | 找到根本因子(這個「真因」)後,接點一才有清楚的內容可以傳遞到 Step 4 目標設定 | 找到根本因子(真因的最佳候選)後,接點一才有清楚的內容可以傳遞到 Step 4 目標設定 | EFA 找到的是能共同解釋多項異常的因子,仍需驗證才能確認為真因 |
| 3 | 3-12 Allen 的現場筆記標題 | 「先驗後探」的常見誤用 | 別讓 EFA「只探不驗」 | 學術慣例為先 EFA 再 CFA,筆記末段也如此建議;真正要批評的是探索之後沒有驗證 |
| 4 | 3-12 同筆記首句 | 我看過太多次顧問圈「先探後驗」的誤用 | 我看過太多次顧問圈「只探不驗」的誤用 | 同第 3 項 |
| 5 | 3-12 圖 3-2 圖題 | 分析階段三步驟的資料流:KRI/KPI → CFA → EFA | 分析階段資料流:KPI 現象 → CFA 推論 → KRI 事實 → EFA 真因 | 與現行七步驟順序一致;圖內箭頭若為舊順序須一併重繪 |
| 6 | 3-22 反思題第 3 題 | 「先驗後探」與「先探後驗」的差別,你經驗中遇過哪一種誤用? | 「先驗後探」與「只探不驗」的差別,你經驗中遇過哪一種誤用? | 與第 3、4 項用語一致 |
| 7 | 3-26 詞彙索引「How so?」 | 對應 CFA──「你猜的因果,資料同意嗎?」 | 對應 CFA──「你猜的原因,資料支不支持?」 | 與第 1 項一致 |
| 8 | 3-26 詞彙索引「Why so?」 | 金字塔 Step 3 提問 | 金字塔 Step 3.5 提問 | 步驟編號錯誤 |
| 9 | 3-26 詞彙索引「根本因子」 | root factor | root cause | 與正文 3-7、3-11 用詞一致 |
說明:3-23 頁本章摘要「分析階段的關鍵規則是『先驗後探』」維持不變。該規則描述的是金字塔的步驟順序(有假設先驗證,再挑戰表面結論),與學術上「探索之後應再驗證」並不衝突;修正第 3、4、6 項後即無矛盾。
三、補充說明
▶ 補充說明|本章如何借用 CFA 與 EFA
CFA 與 EFA 原本是統計學中的因素分析方法,用來找出「許多指標背後共同的影響來源」。例如誤揀、漏揀、超時常常一起變差,背後可能是同一個「人因疲勞」在影響。
在統計學中,兩者都有嚴謹的檢定程序:EFA 從資料中歸納出可能的因子,CFA 則檢驗事先設定的因子結構是否與資料吻合。兩階段決策金字塔借用的是它們的思維精神,不要求讀者每次都跑完統計程序:
- Step 2 的 CFA 精神:先寫下假設,再拉資料驗證。分組比較、交叉比對都算。
- Step 3.5 的 EFA 精神:先放下既有假設,讓資料呈現哪些異常總是一起出現。
使用時要記住兩件事:
- 資料支持某個假設,不等於證明了因果。
- EFA 找到的因子是真因的最佳候選,最好再用新一期的資料驗證一次,再交給 Step 4 設定目標。
註:CFA(驗證性因素分析)與 EFA(探索性因素分析)原為統計學方法,本章取其思維精神:Step 2「先寫假設再驗證」、Step 3.5「放下假設讓資料分群」。資料支持假設不等於證明因果;EFA 找到的是真因候選,宜以新一期資料再驗證後,再進入目標設定。
CH03 ・ 講師版補充說明|2026-10-09
第 3 章 兩階段決策金字塔:講師版補充說明
前往第 3 章 →一、使用說明
本補充說明不改變定稿正文的架構,但在授課時,以下補充定義優先於正文中較簡化的寫法。重點有四:
- CFA 與 EFA 在本章是「思維精神」,不是嚴格的統計程序。
- 分析階段由觀察提出競爭假設,再加以驗證,藉此把「由下而上」與「先寫假設」接起來。
- Step 3.5 的「探索」是先擴大變數範圍,再讓資料分群;找到的是真因的最佳候選。
- 回應階段採「先排序、後承諾」,並用追溯表確保對策打在根本因子上。
本節中的數值皆為教學示例假設值,非業界基準。
二、七步驟補充定義
| 步驟 | 正文寫法(簡化) | 講師補充定義 |
|---|---|---|
| Step 1So What? 現象觀測 | 聚焦底層 KPI;KRI 留到 Step 3 | 迭代收集 KPI 與 KRI 的事實資訊,並先加以區分:KPI 是領先指標(過程做得好不好),KRI 是落後指標(成果有沒有達標)。只做觀測與分類,不做因果推論。KRI 偏離目標,通常就是啟動分析的訊號。 |
| Step 1→2提出假設 | (正文未明寫) | 由觀察到的現象提出至少 3 個互相競爭的假設,例如新人比例、天候、系統介面延遲。這在方法論上屬於溯因推理(Abductive Reasoning),可以把「由下而上」和「先驗證假設」接起來。只驗證一個假設,正是「替罪羊式歸因」的成因。 |
| Step 2How so? CFA 驗證 | 「你猜的因果,統計說得同意嗎?」 | CFA 精神:先寫下假設,再拉資料驗證,分組比較、交叉比對都算。授課時改說「你猜的原因,資料支不支持?」。資料支持假設,不等於證明了因果。 |
| Step 3So What? 事實陳述 | 把 CFA 的合理推論收斂為頂層 KRI | 以 Step 2 驗證過的影響路徑,說明 KRI 與目標之間的落差從何而來(KPI → KRI),形成分析金字塔頂層的結論性陳述。 |
| 閘門是否進入 3.5 | 正文一處說「不能跳過」,另一處說「假設不成立才轉 EFA」 | 如果 CFA 驗證的路徑能解釋大部分 KRI 落差,而且是可以直接採取行動的層級,就直接進入 Step 4;否則進入 Step 3.5。 |
| Step 3.5Why so? EFA 探索 | 沒有假設、讓資料自己分群,找出根本因子 | 探索分兩層:(1) 擴大變數範圍,刻意納入前三步報表上沒有的變數,例如班表、工時、薪資級距、離職率、士氣、主檔異動、排程設定等;(2) 讓資料分群,找出共同因子。找到的是真因的最佳候選,最好再用新一期資料驗證一次,再交給 Step 4。 |
| Step 4目標設定 | 同時設定 Target KRI 與 Execution KPI | 針對每個根本因子擬出候選目標(Target KRI 與 Execution KPI 兩條線),暫不定案。 |
| Step 5Why should? IPA 取捨 | 回答「為何應該」,用四象限排優先序 | IPA 本質是排序工具:在多個根本因子或候選目標之間決定先做、後做、不做。重要性必須從顧客或策略視角打分。 |
| Step 6How should? OGSM 展開 | 四層展開為可追蹤行動 | 對應關係:O=願景;G=Step 4 定案的 Target KRI;S=IPA 選出的策略;M=Execution KPI(含負責人、時程)。每條 S 都要能追溯到某個根本因子(見第四節)。 |
授課提示|分析金字塔的完整動線
觀察並區分 KPI/KRI → 提出 3 個以上競爭假設 → CFA 驗證 → 說明 KRI 落差的事實陳述 →(閘門)→ 擴大變數、EFA 分群 → 真因候選 → 新一期資料再驗證 → 進入回應階段。
三、Step 3.5 範例的講述方式
正文 3-11 頁的因子 A「人因疲勞」,原意是指造成疲勞的排班、薪酬、士氣等條件,而不是疲勞現象本身。授課時建議以下列方式重述,讓學員看見「擴大變數 → 分群」的動作:
示例:前三步只用了報表上現有的 KPI/KRI。Step 3.5 刻意納入不在報表上的變數,例如班表型態、連續工時、加班時數、薪資級距、離職率、士氣調查分數、貨品主檔異動次數、批次排程時間等,和三週內的倉儲異常變數一起分析,常會分出兩到三個共同因子:
- 因子 A「人力配置與工作負荷」(即正文的「人因疲勞」):班表、連續工時、加班時數、士氣分數,與誤揀、漏揀、超時同步變動。
- 因子 B「主資料治理」:主檔異動頻率,與入庫不準、盤差、訂正次數同步變動。
- 因子 C「介面時差」:批次排程設定,與 WMS/ERP 帳差、補貨晚點、訂單延遲同步變動。
薪酬、士氣這類變數通常不在 WMS 裡,需要向人資取得資料或做簡短問卷。這正是 Step 3.5 和前三步最大的不同。
授課提示|資料量
統計上的 EFA 一般需要數百筆觀測,至少為變數數的 5〜10 倍。「三週、20 項變數」若以「天」為分析單位只有 21 筆,不足以跑統計版 EFA。教學上可以改以「班次 × 作業員」或「訂單」為分析單位以增加筆數,或直接採用第五節的輕量工具。
四、回應階段:根本因子追溯表
回應階段建議採「先排序、後承諾」:Step 4 擬候選目標 → Step 5 用 IPA 排序 → Step 6 以 OGSM 定案展開。展開時,用下表檢查每條策略是否打在根本因子上。
| 根本因子 | G(Target KRI) | S(策略) | M(Execution KPI/負責人) |
|---|---|---|---|
| A 人力配置與工作負荷 | 誤揀率 ≤ 0.3% | 班表重排,設定連續工時上限 | 單班連續工時 ≤ 10 小時(倉主任)示例 |
| A 人力配置與工作負荷 | 同上 | 新人 OJT 輪崗制度改為 4 週 | 新人 OJT 時數 ≥ 12 小時/月(倉主任) |
| B 主資料治理 | 貨品主檔異動錯誤率 ≤ 0.02% | 貨品主檔治理 RACI 重新分工 | 主檔 Data Steward 輪值表(資訊部) |
| (監測機制) | 年度盤點準確率 99.1% → 99.7% | WMS 每週循環盤點 | 盤點週循環率 ≥ 95%(WMS 管理員) |
說明:正文範例 ① 的策略中沒有直接處理工時與班表的項目,建議授課時補上第一列。每週循環盤點屬於「偵測與監測」,應標示為監測機制,不視為根本因子對策。
| 根本因子 | G(Target KRI) | S(策略) | M(Execution KPI/負責人) |
|---|---|---|---|
| 路況波動 | 配送誤點率 8% → ≤ 3% | 動態路徑再規劃接入天候 API | 每週路線再規劃 ≥ 3 次(調度組) |
| 介面時差 | 客訴率 ≤ 0.5% | TMS 與 OMS 改為事件驅動介面 | TMS 事件延遲 ≤ 2 分鐘(IT 組) |
| (SX 策略性加入) | Scope 1 排放年減 5% | 電動車試點 10 台 | 電動車月度規劃里程達成率 ≥ 95%(車輛組) |
說明:電動車試點不是由根本因子推導而來,而是 SX 永續目標的策略性加入。可以保留,但應明確標示,避免學員誤以為所有策略都來自分析階段。
五、輕量工具對照(給 L1〜L2 組織的學員)
| 步驟 | 精神 | 建議的輕量工具 |
|---|---|---|
| Step 1→2 | 提出競爭假設 | 假設清單(至少 3 個),每個假設附上「要拉哪張報表驗證」 |
| Step 2 | 先寫假設再驗證 | 分組比較、交叉表、柏拉圖(Pareto Chart) |
| Step 3.5 前段 | 擴大變數、症狀分群 | 跨部門資料以訂單號串接;相關係數熱圖;同時異常次數統計 |
| Step 3.5 後段 | 真因追問與確認 | 五個為什麼(5 Whys)、魚骨圖(Ishikawa Diagram)、到現場確認(Gemba) |
| 迴圈 | 效果驗證 | 導入前後比較;先在單一站點試行,再全面推行 |
六、迴圈頻率與成熟度的補充定義
迴圈頻率(補充正文 3-16 頁)
- 日迴圈:現場異常處理(KPI 監控 + 即時處置)。不必每天都跑 CFA/EFA。
- 週/月迴圈:戰術調整(CFA/EFA + IPA 再排 + KRI 對齊),完整跑 Step 1–5。IPA 排序的結果用來調整既有 OGSM 的 M(具體行動)與資源分配,不更動 O、G、S。
- 季/半年/年迴圈:戰略修訂(KRI 全面檢討 + OGSM 重設),完整跑 Step 1–6。視組織規模與環境變動速度,選擇季、半年或一年一次。
分工原則:戰術層只調整 M,戰略層才重設 G 與 S。這也正好回答正文 Route 灰框的「砍 Measure 還是 Strategy」。
Logi-Twin 成熟度 L4(補充正文 3-16 頁)
L4 領導期:封閉迴圈內的頻率達週級或即時;能主動預警。在 KPI 領先訊號偏離、KRI 尚未惡化之前,就啟動 CFA 驗證或 EFA 探索。
與 L3 的區別:L3 是 KRI 出事、在月度迴圈才分析;L4 是 KPI 一偏離就啟動分析。
七、學員常見質疑與建議回應
Q1CFA 可以證明因果嗎?
不行。嚴格的 CFA 檢驗的是事先設定的因子結構是否與資料吻合。本章借用的是「先寫假設、再用資料驗證」的精神;資料支持假設,只代表這個解釋站得住,不等於證明因果。
Q2EFA 找到的就是真因嗎?
是真因的最佳候選。EFA 只能在已經納入的變數中找出共同變動的群組,所以 Step 3.5 要先擴大變數範圍;找到的因子最好再用新一期資料驗證,必要時搭配 5 Whys 或現場確認。
Q3學術上是先 EFA 探索再 CFA 驗證,為什麼本章說「先驗後探」?
兩者講的是不同的事。「先驗後探」指金字塔的步驟順序:有假設先驗證,再挑戰表面結論。學術上「探索之後要再驗證」本章也同意(Step 3.5 之後以新一期資料再驗證)。真正要避免的是「只探不驗」:分群結果故事說得順,就直接當結論。
Q4分析要由下而上、不能先設立場,Step 2 卻要先寫假設,不矛盾嗎?
不矛盾。假設是從 Step 1 的觀察「長出來」的(溯因推理),而且至少要有 3 個互相競爭。先設立場的問題在於只有一個預設答案,而不是有假設。
Q5Step 3.5 一定要跑嗎?
看閘門規則。CFA 驗證的路徑能解釋大部分落差、而且可以直接採取行動,就進入 Step 4;解釋不了,或找到的只是症狀層級的原因,才進入 Step 3.5。
Q6KPI 是領先指標、KRI 是落後指標,是 Parmenter 的原始分法嗎?
不完全是。Parmenter 原書把指標分為 KRI、RI(結果指標)、PI(績效指標)、KPI 四類。本章參考其觀點並簡化為「KPI 領先、KRI 落後」兩類,方便教學與實務溝通。
Q7三週資料夠跑 EFA 嗎?
以「天」為單位不夠。統計版 EFA 需要數百筆觀測;可改以班次、作業員或訂單為分析單位,或採用第五節的輕量工具,保留探索精神即可。
八、章前情境推演(課堂演練用)
以「藍海 3PL 週一跨部門會議」帶學員走一輪七步驟:
| 步驟 | 演練重點 |
|---|---|
| Step 1 | 三份報表(盤虧、誤點、客訴)都是 KRI,是啟動分析的訊號;請學員補列可以對照的 KPI(揀貨時效、出貨準時率、訂單回應時效等),並區分兩類。 |
| Step 1→2 | 三位主管的說法正好是三個競爭假設:新人太多、連下三天雨、倉儲運輸沒顧好。請學員為每個假設寫出「要拉哪張報表驗證」。 |
| Step 2–3 | 逐一驗證後,寫出一句事實陳述:KRI 落差主要來自哪些已驗證的路徑。 |
| 閘門 | 若三個假設都只能解釋一部分,進入 Step 3.5。 |
| Step 3.5 | 關鍵前提:倉儲、運輸、客服的資料必須能用訂單號串接,才能回答「三件事是不是同一件事」。再擴大變數,例如班表、天候、系統排程時間。 |
| Step 4–6 | 為每個根本因子擬候選目標 → 用 IPA 排序 → 以 OGSM 展開,並填寫第四節的追溯表。 |
| 迴圈 | 約定一個月後用導入前後比較檢查成效,回到 Step 1。 |
CH05 ・ 勘誤表|2026-10-04
第 5 章 儲位規劃與空間優化
前往第 5 章 →| # | 位置 | 原文 | 勘誤 |
|---|---|---|---|
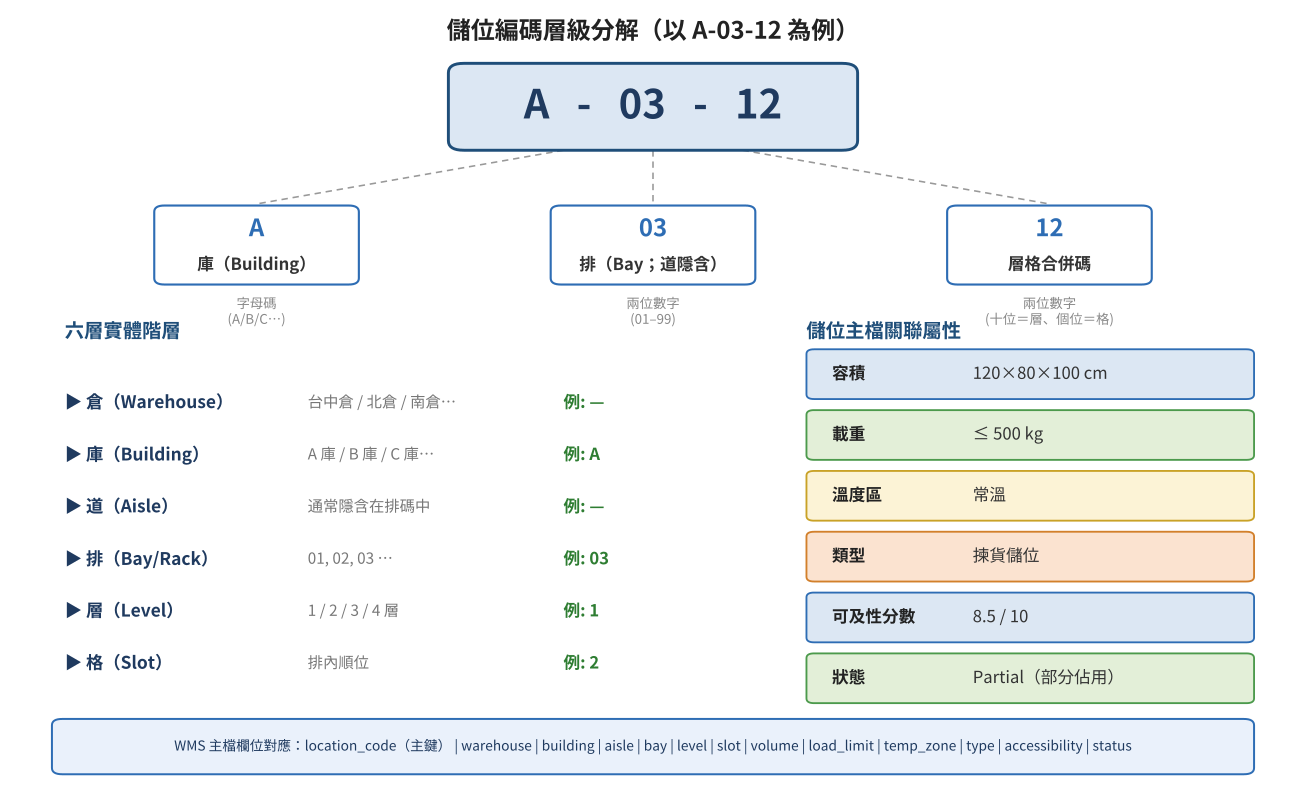
| 1 | §5.1 編碼規則說明段 | 例 A-03-12 = A 庫第 03 排第 12 層×格 | 例 A-03-12 = A 庫第 03 排、層格合併碼 12(第 1 層第 2 格) |
| 2 | 工具一 Ware 倉填入示範 | A 區共 10 排、每排 6 層、每層 12 格;編碼為「A-NN-NN」格式(區-排-層格合併),共計 720 個常溫儲位 | A 庫共 10 排、每排 6 層、每層 9 格;編碼為「A-NN-NN」格式(庫-排-層格合併),共計 540 個常溫儲位 |
| 3 | 工具一 Ware 倉填入示範 | 預留空位策略:每排第 9–10 層暫不啟用 | 預留空位策略:每排第 7–9 層暫不啟用 |
| 4 | 圖 5-1 右框 | 層×格 編號 兩位數字(01–24) | 層格合併碼 兩位數字(十位=層、個位=格) |
| 5 | 圖 5-1 左表「格」 | 例:12 | 例:2 |
| 6 | 圖 5-1 左表標題 | 六層物理階層 | 六層實體階層 |
| 7 | 圖 5-1 左表「倉」 | 華倉 / 北倉 / 南倉… | 台中倉 / 北倉 / 南倉… |
說明
- A-NN-NN 簡式編碼中,第二組兩位數為層格合併碼:十位數為層(由地面往上從 1 起算),個位數為格(由靠主道的一端往內編號)。層數或格數超過 9 時,改用拆分寫法,例如 A-03-1-12(第 1 層第 12 格)。
- 第 2 項每層格數改為 9 格,使示範倉可用合併碼表示;常溫儲位總數隨之由 720 調整為 540(10 排 × 6 層 × 9 格)。
- 圖 5-1 已更新為 v3(彩色版與黑白版內容相同),勘誤項目 4–7 已套用。